Kategorie: Linux

Digitales Archiv – mein Ansatz

Mein persönlicher Ansatz zum digitalen Archiv, hier einmal etwas eingehender beschrieben. Evtl. findet es jemand nützlich? Das ganze ist auf Linux-Systeme ausgerichtet, vom Prinzip funktioniert sollte es aber unter allen System umsetzbar sein, die Dateien/Ordner verwenden. Das ist auch die Grundidee, es soll völlig plattformunabhängig funktionieren. Ich mag Basteln am Computer – auch wenn ich beruflich nichts mit IT zu tun habe. Irgendwann stellte sich dann einmal die Frage, was mit alten Unterlagen (damals waren es tatsächlich u.a. noch Klassenarbeiten und später Oberstufen-Klausuren) passieren sollte. Kistenweise Aufheben wollte ich nicht, wegschmeißen aber irgendwie auch nicht. Es lag nahe, sie digital aufzuheben, die Originale brauchte ich fürs Gefühl nicht mehr, wenn ich alles digital archiviert hätte. Letztlich ist so ein digitales Archiv entstanden, was jetzt mehr als 15 Jahre alt ist und stetig weiter wächst. Anfangs mühsam mit irgendeinem Scan-Programm einzeln gescannt und als jpg-Dateienabgelegt, bin ich natürlich dann auch irgendwann mit dem Thema OCR in Kontakt gekommen. Und etwas später dann mit Linux.

Grundprinzipien

Im Internet finden sich ebenfalls einige Artikel zu dem Thema, insbesondere Blogeinträge von Leuten mit ähnlichen Gedanken fand ich spannend. Gedanken heißt in dem Fall:

  • Die Unterlagen (meist Briefe im DIN A4 Format) sollen langfristig lesbar gespeichert werden (nicht 100 Jahre oder so, aber in 20 Jahren möchte ich sie schon gerne noch lesen können). Letztlich kommt man dann meist auf PDF. Djvu hatte ich auch mal probiert, bin aber wieder davon abgekommen. Wird nicht genug unterstützt.
  • Platzsparend. Also: Unterlagen als Schwarz-Weiß Scan ablegen, optimieren. Das Archiv ist auch so schon groß genug (~30 GB aktuell, aber auch mit vielen nicht-Dokumenten)
  • Durchsuchbar. Sprich: OCR soll natürlich benutzt werden, ich möchte mit einem entsprechenden Indexer (Recoll nutze ich dafür) Dinge finden können, bei denen ich mich nicht mehr an Dateinamen oder Speicherort erinnern kann. Um nach Dateien im Archiv anhand des Dateinamens zu suchen, nutze ich ganz einfach das Unix-Standardtool locate (mit etwas Bashscript-Hilfe, sodass je nach Befehl nur das Archiv durchsucht wird und nicht die ganze Platte).
  • Unabhängig. Damit ist unabhängig von irgendwelchen Software(-Herstellern), Formaten, Dateisystemen, Datenbanksystem, Betriebssystemen usw. gemeint. Einfach Dateien in Ordnern, ganz simpel.
  • Einfach. Sowohl beim Suchen (In den Ordnern nachschauen oder auch Recoll benutzen ist einfach, finde ich), als auch beim Befüllen. Im Internet finden sich Beschreibungen von (meiner Meinung nach) komplizierten Tag-Strukturen. Z.b. wurden Tags im Dateinamen abgelegt, und mit Sonderzeichen getrennt. Dann konnten sich alle Dateien in einem Ordner ansammeln und man kann einfach nach Tags durchsuchen. Das hat den Vorteil, dass man sich nicht entscheiden muss, ob man die Rechnung für die KFZ-Versicherung nun unter Auto ablegt oder unter Versicherungen. Das ist ein guter Ansatz. Aber hätte ich in den letzten 15 Jahren alles in einem (oder einer Hand voll) Ordner abgelegt, dann würde ich – glaube ich – aktuell nichts mehr gut finden. Die Disziplin, immer korrekte Tags zu vergeben (oder Tippfehler?), hätte ich vermutlich nicht gehabt. Ich habe mich daher einfach für Ordner entschieden, wie oben erwähnt. Das finde ich unheimlich einfach. Hin und wieder muss man für sich selber festlegen, ob man nun die Rechnungen für die Kasko-Versicherung eben unter Versicherungen verstaut oder im Auto-Ordner – aber man kann das auch ganz simple lösen, indem man einfach einen Softlink anlegt (oder meinetwegen Hardlink) und fertig. Mit der Zeit weiß ich aber einfach meist, wo ich Dinge ablege, die ich immer mal wieder brauche. Für alles, an das ich mich nicht erinnern kann, habe ich locate (die Dateisystem-Suche unter Linux) und wenn das immer noch nicht hilft, den Indexer, also recoll.

Hier eine beispielhafte Ordnerstruktur (nicht vollständig, der Privatsphäre wegen):
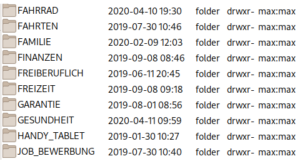
Beispiel Ordnerstruktur
Die Dateien werden nach diesem Schema benannt:

JJJJ-MM-DD_Firma_oder_Organisation_etc_Titel_des_Dokuments.pdf

also z.b.

2019-10-14_TK_Versicherungsbescheinigung.pdf

Und die liegt dann in

VERSICHERUNGEN/Krankenversicherung/

Ich habe irgendwann einmal die groben Kategorie-Ordner in Großbuchstaben geschrieben, warum auch immer, aber das spielt eigentlich keine Rolle.

Archiv befüllen

Vor allem das Bewerkstelligen des einfachen Befüllens hat anfangs etwas Mühe gekostet, denn ich habe auf die Schnelle kein Programm gefunden, was Dokumente scannt, auf schwarz-weiß optimiert, OCR durchführt und alles als PDF abspeichert – noch dazu, wenn ein Dokument aus mehreren Seiten besteht (z.B. Vorder- und Rückseite). Natürlich gibt es Tools, die das können, und noch viel mehr. Ich wollte es aber auch gerne auf der Kommandozeile haben, sodass ich einfach nur einen Befehl eingeben muss wenn das Papier im Scanner liegt, und der Rest wird erledigt. Dafür habe ich mir ein Python-Tool geschrieben, das genau das tut. Für komplexere Dokumente, mit Seiten im Querformat (die also nach dem Scannen gedreht werden müssen) und vielen Seiten nutze ich manchmal einfach Simple-Scan (und führe die OCR im Anschluss über ein anderes, selbst geschriebenes Script durch).

Der übliche Ablage-Stapel auf dem Schreibtisch muss dann nur noch einigermaßen regelmäßig durchgeschaut werden – unnötiges wandert in den Papiermüll, wichtiges wird eingescannt und wandert dann in den Papiermüll. Sehr wichtiges wird analog aufbewahrt, Bescheinigungen und so weiter, also Dinge, die man als Original aufheben möchte. Die landen dann eben doch in einem Ordner, aber dafür reichen mir inzwischen 2 Stück (einer für Privates, einer für Arbeit). Damit fällt das Papier-Archiv unheimlich schlank aus und ich habe alles, was dort im Ordner abgeheftet ist, auch vernünftig einscannt und durchsuchbar digital verfügbar.

Backup

Selbstverständlich braucht es eine regelmäßige Sicherung. Externe Festplatten, regelmäßig synchronisiert und an unterschiedlichen Stellen aufbewahrt, sollten hier für passable Sicherheit sorgen. Ich nutzte restic als Backup Software und habe 2 externe Festplatten die regelmäßig befüllt werden und an zwei völlig anderen Orten lagern, sodass selbst ein Wohnungs- oder Hausbrand mich höchstens ein paar Tage an Daten kosten würde (neben dem ganzen anderen Ärger).

Aktuelle Struktur
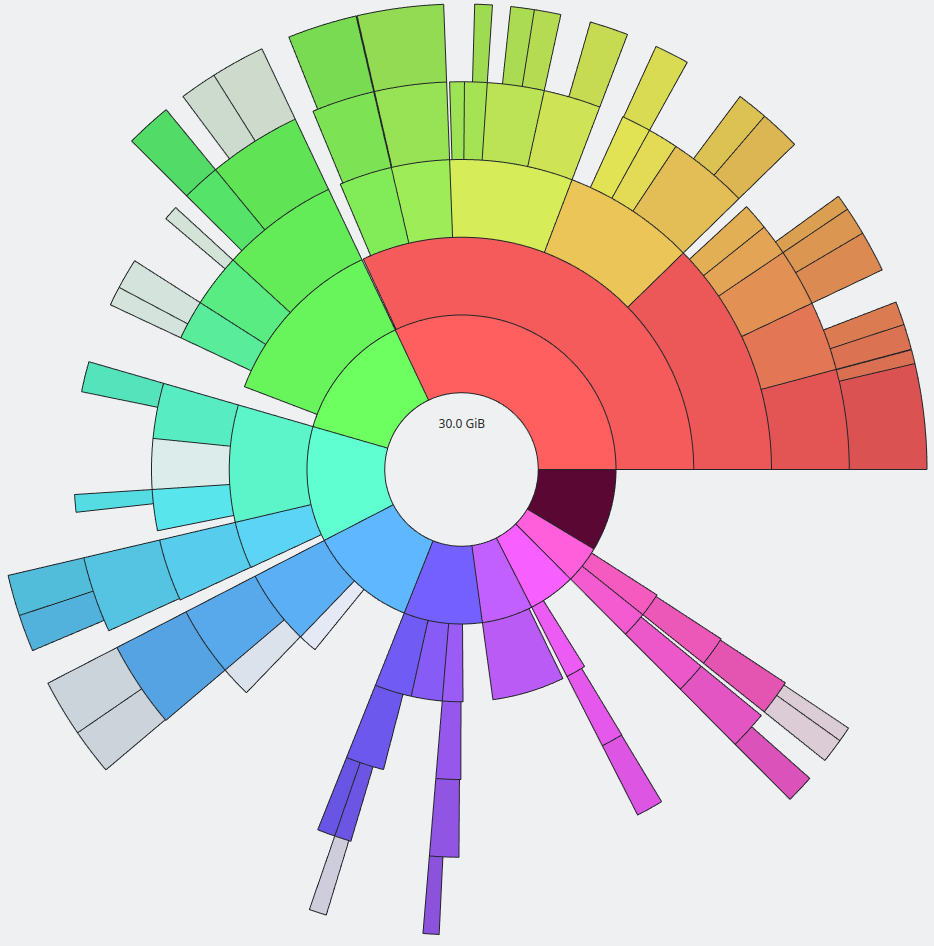

(mit filelight erstellt)

Fonts unter Arch Linux

Um die unglaubliche Menge an installierten Fonts mal etwas zu reduzieren bin ich bei der Suche u.a. auf diesen Reddit-Post gestoßen. Grober Inhalt:

  • ttf-google-fonts-git kann man durch adobe-source-code-pro-fonts ersetzen.
  • noto-fonts kann durch noto-fonts-lite ersetzt werden
  • noto-fonts-extra braucht es nicht unbedingt

Allein das reduziert schonmal erheblich die Menge der installierten Fonts, die ich eh nicht brauche. Aber die Pakete sind ja teilweise Abhängigkeiten von Thunderbird/Chromium/etc.

Thinkpad X13: Bildschirm wechselt nur noch durch die RGB Farben

Plötzlich, nach dem Starten aus dem Suspend-Modus, blinkt der Bildschirm nur noch in den Grundfarben (Weiß/Schwarz/Rot/Grün/Blau). Nichts anderes geht mehr. Aber: Ein externer Bildschirm zeigt noch die normale Anzeige, man kann sogar bedienen? Defekt? Zum Glück nicht:

Es ist ein bekanntes Problem, auch wenn ich auf die Schnelle die genaue Ursache nicht eruieren konnte. Auf der Unterseite des Notebooks gibt es aber ein winziges Loch, mit einer Nadel z.B. kann man vorsichtig hinein pieken und damit den Restknopf auslösen. Danach geht alles wieder wie vorher.

Quelle: https://www.reddit.com/r/thinkpad/comments/miai5r/my_ryzen_7_x13_is_flashing_colors_rgb_on_the/

screen terminfo und Bedienungs-Basics

screen verwende ich gerne in der Konsole, z.B. auf dem Server oder Nas. Hier zum schnellen Nachschauen die Standard-Befehle und der nervige terminfo-Fehler.

Wenn

Cannot find terminfo entry for 'rxvt-256color'.

kommt, dann einfach

export TERM='linux'

verwenden (wahlweise in die bashrc einfügen).

Basics Keyboard:
Ctrl + d + a = detach

screen -r = reattach

screen -l = list sessions

Neues PGP-Keyserver System

Seit 2019 gibt einen alternativen Keyserver zu dem bisherigen System aus verteilten Keyservern auf Basis einer Software (SKS), die untereinander den Datenbestand synchronisieren und bei denen man beliebige Schlüssel hochladen konnte. Das hatte zu teils erheblichen Problemen geführt, da die Funktionen missbraucht wurden um Schlüssel mit Nonsense zu füllen und damit die Server lahmzulegen. Genauer steht es auf Golem beschrieben.

Der neue Keyserver, https://keys.openpgp.org/, erfordert eine Bestätigung über einen Link, der an die enthaltenen E-Mail Adressen geschickt wird. Damit ist es zumindest deutlich schwieriger, gefälschte Schlüssel einzuschleusen.

Dieser neue Schlüssel wird von Enigmail standardmäßig verwendet, damit auch gpg (z.B. auf der Kommandozeile) ihn nutzt muss man in der Konfigurationsdatei ~/.gnupg/gpg.conf etwas ändern. Der bisherige Eintrag für den keyserver wird auskommentiert und eingefügt wird statt dessen:

keyserver hkps://keys.openpgp.org

Der Nachteil ist, dass natürlich der bisherige Datenbestand nicht übernommen werden konnte (und sollte), man muss daher den eigenen Schlüssel neu hochladen und bestätigen.

evince erkennt djvu Dateien nicht mehr

Ich archive fast alles digital. Meist verwende ich das PDF-Format, weil es der de-facto Standard ist. Im Grunde gefällt mir aber djvu besser – die Dateien sind meist kleiner, Grafiken bzw. komplexe Layouts in eingescannten Dokumenten werden auch mit Texterkennung perfekt platziert. Mehr zu den Vor- und Nachteilen findet sich z.B. hier.

Evince als kleiner, quelloffener Document Viewer kann auch djvu anzeigen, hat diesen Dienst aber vor ein paar Monaten plötzlich verweigert. Eine Lösung habe ich jetzt gefunden:

/usr/lib/evince/4/backends/djvudocument.evince-backend (unter Arch):

In der letzten Zeile einfach folgendes noch hinten ergänzen:

image/vnd.djvu;

Und schwupps: evince öffnet wieder djvu Dateien. Quelle der Lösung: Ubuntu Forum.

Scanner unter Linux: Brother DSmobile 620: Error during device I/O

Auf der Suche nach einem Einzugscanner, der schneller arbeitet als mein alter Scanner, unter Linux läuft und halbwegs bezahlbar ist, bin ich auf den Brother DSmobile 620 gestoßen.

Für Arch Linux gibt es sogar ein Paket im AUR für die passenden Sane-Treiber. Der Scanner lief damit problemlos, ob mit xsane, gscan2pdf oder selbstgebauten bash-scripts zum schnellen Scannen.

Nach einigen Tagen ohne Scannen wollte das Ding aber nicht mehr:

scanimage: open of device dsseries failed: Error during device I/O

Bekomme ich nur noch als Fehlermeldung, sane findet den Scanner einfach gar nicht mehr. Alle Forensuche endet im Nirvana, die FAQ auf der Brother-Website sowieso. Zum Äußersten schreiten und das Gerät an einen Windows-Rechner hängen zeigt: Am Scanner liegt’s nicht, der läuft. Firmware aktualisiert: auch kein Effekt (aber war sicher auch mal sinnvoll).

Die Lösung nach vielem Suchen: Ein SCSI Modul muss geladen sein. Leider macht sane das nicht selbst. Nach einem simplen

modprobe sg

läuft alles wieder…

Thinkpad thinkfan: hwmon-Gerätedateien ändern sich bei jedem Reboot

Um thinkfan für die Lüfterverwaltung beim thinkpad verwenden zu können, muss man in der Config-Datei die entsprechenden Temperatursensoren eintragen. Bei mir sind das:

hwmon /sys/devices/virtual/hwmon/hwmon1/temp1_input
hwmon /sys/devices/virtual/hwmon/hwmon2/temp1_input
hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon3/temp3_input
hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon3/temp1_input
hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon3/temp2_input

Problematisch: Bei einem Reboot änderten sich die Namen geringfügig, z.b. hwmon1 und 3 statt 0 und 2. Dadurch brach thinkfan nach jedem Reboot direkt nach dem Start mit einer Fehlermeldung ab, weil die eingetragenen Sensoren nicht gefunden werden konnten

Hier und hier kommt die Lösung her, mit der sich die Dateinamen nicht mehr ändern:

Mit Hilfe von sensors-detect die nötigen Kernelmodule herausfinden, die werden dann automatisch in /etc/conf.d/lm_sensors geschrieben. Anschließend genau diese Module dann „blacklisten“, sodass sie nicht mehr automatisch geladen werden beim Systemstart und in der lm-sensors Konfigurationsdatei dann in einer festen Reihenfolge angeben, damit die Nummerierungen immer gleich bleiben.

Für das X250:

/etc/modprobe.d/thinkfan.conf

blacklist i2c-dev
blacklist cpuid
blacklist coretemp
blacklist i2c_i801

/etc/conf.d/lm_sensors

HWMON_MODULES=“i2c-dev i2c_i801 cpuid coretemp“

HWMON_MODULES="i2c-dev i2c_i801 cpuid coretemp"

Dann Neustarten und die thinkfan.conf ein letztes mal den aktuellen Sensorennamen entsprechend anpassen.

So bleibt es bei mir stabil. Danke an die arch bbs und ubuntuforums.org für die Lösung.

Lüftersteuerung unter Linux beim X250 mit thinkfan

Das neue Notebook gewöhnt sich gerade ein – oder eher: Ich gewöhne mich daran. Sehr irritiert hat mich aber noch der gefühlt ständig laufende Lüfter – bei eigentlich kaum nennenswerter Beanspruchung (abgesehen von den sehr sommerlichen Temperaturen gerade).

Das Modul thinkpad_acpi ist geladen (mit fan_control=1). Leider fehlt bei mir /proc/acpi/ibm/thermal, also die Temperatursensoren werden scheinbar vom Modul (noch) nicht erkannt. Beim X201 hatte (glaube ich) tpfanco die Lüftersteuerung übernommen. Das scheint aber ohne /proc/acpi/ibm/thermal erst einmal nicht zu funktionieren (oder ich habe nicht genug recherchiert). Beim Suchen nach einer Lösung für dieses Problem bin ich auf eine schöne Anleitung bei thinkwiki.de gestoßen, die das Suchen von Sensoren über lm-sensors erklärt. Zusammen mit dem Tool thinkfan lässt sich die Lüftersteuerung dann ganz leicht individuell steuern:

  • Als Erstes nach der Anleitung die Sensoren ausfindig machen. Das sind bei meinem X250:
    /sys/devices/virtual/hwmon/hwmon0/temp1_input
    /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp3_input
    /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp1_input
    /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp2_input
  • Dann eine thinkfan config Datei anlegen (nach der Vorlage unter /usr/share/doc/thinkfan/examples/thinkfan.conf.simple). Meine sieht jetzt erst einmal so aus:
    tp_fan /proc/acpi/ibm/fan
    
    # X250
    hwmon /sys/devices/virtual/hwmon/hwmon0/temp1_input
    hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp3_input
    hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp1_input
    hwmon /sys/devices/platform/coretemp.0/hwmon/hwmon2/temp2_input
    
    (0,	0,	58)
    (1,	57,	62)
    (2,	60,	64)
    (3,	62,	65)
    (4,	63,	66)
    (5,	65,	67)
    (7,	66,	32767)

    Achtung! Die Werte sind noch nicht viel getestet und könnten zu hoch liegen und damit das Gerät beschädigen!

  • thinkfan als root im Testbetrieb starten, sodass man sieht was passiert:
    thinkfan -n
  • Wenn alles passt, thinkfan automatisch als daemon starten lassen (mit systemd, sysvinit, was auch immer man verwendet).

Ich hoffe das funktioniert auch weiterhin so gut. Dann wäre das Lüfter-Problem gelöst.